Inputless DB
Database a grafo. Documenti in ingresso, sottografo in uscita. Una risposta che potete percorrere.
Cosa ottenete
- •Caricate documenti senza ETL. Ingerite i contenuti direttamente — niente pipeline manuali né passi di trasformazione. Inputless DB accetta i documenti così come sono e costruisce il grafo da quelli.
- •Il grafo viene costruito e riportato automaticamente. Il sistema costruisce e mantiene il grafo dai vostri dati e lo mostra nel Graph Explorer — niente schema costruiti a mano né mapping manuale.
- •Il report di correlazione del grafo collega i dati automaticamente. Le connessioni tra entità, topic, eventi e documenti vengono scoperte e riportate in automatico, così relazioni e spiegazioni restano aggiornate.
- •Scala fino a petaflow. Costruito per gestire flusso e throughput a scala petabyte. Inputless DB è pensato per workload enterprise e di intelligence dove volume e velocità richiedono capacità di grado petaflow.
- •Pensato per ambienti airgapped. Reti isolate, offline o ad alta sicurezza. Nessun public cloud. Nessuna API esterna. Il modello gira dove la connettività è ristretta o vietata.
Come l’abbiamo progettato
Cinque regole che fanno di Inputless DB uno store a grafo per RAG e il Cognitive Substrate, non un property graph generico.
Anticipazione invece di reazione
Funzioni che predicono o precalcolano ciò che servirà, non solo rispondono quando viene chiesto.
Cognitive come first-class
Intento, pattern e stato mentale sono dimensioni primarie del grafo e del retrieval — non filtri secondari.
Spiegazione graph-native
Ogni risposta e decisione si può tracciare fino a un sottografo; la spiegazione è una query, non un log.
Comportamentale + semantico unificati
Stesso grafo e stesse API per «ciò che è stato detto» e «ciò che è stato fatto»; similarità su entrambi.
Delimitato e trasparente
I contratti (tempo, budget di nodi, confidenza) sono espliciti e first-class.
Graph Explorer in azione
Graph Explorer di Inputless DB: tracciate le risposte fino ai sottografi, esplorate tipi di nodo e relazioni e vedete dati cognitivi e comportamentali in una vista unificata.
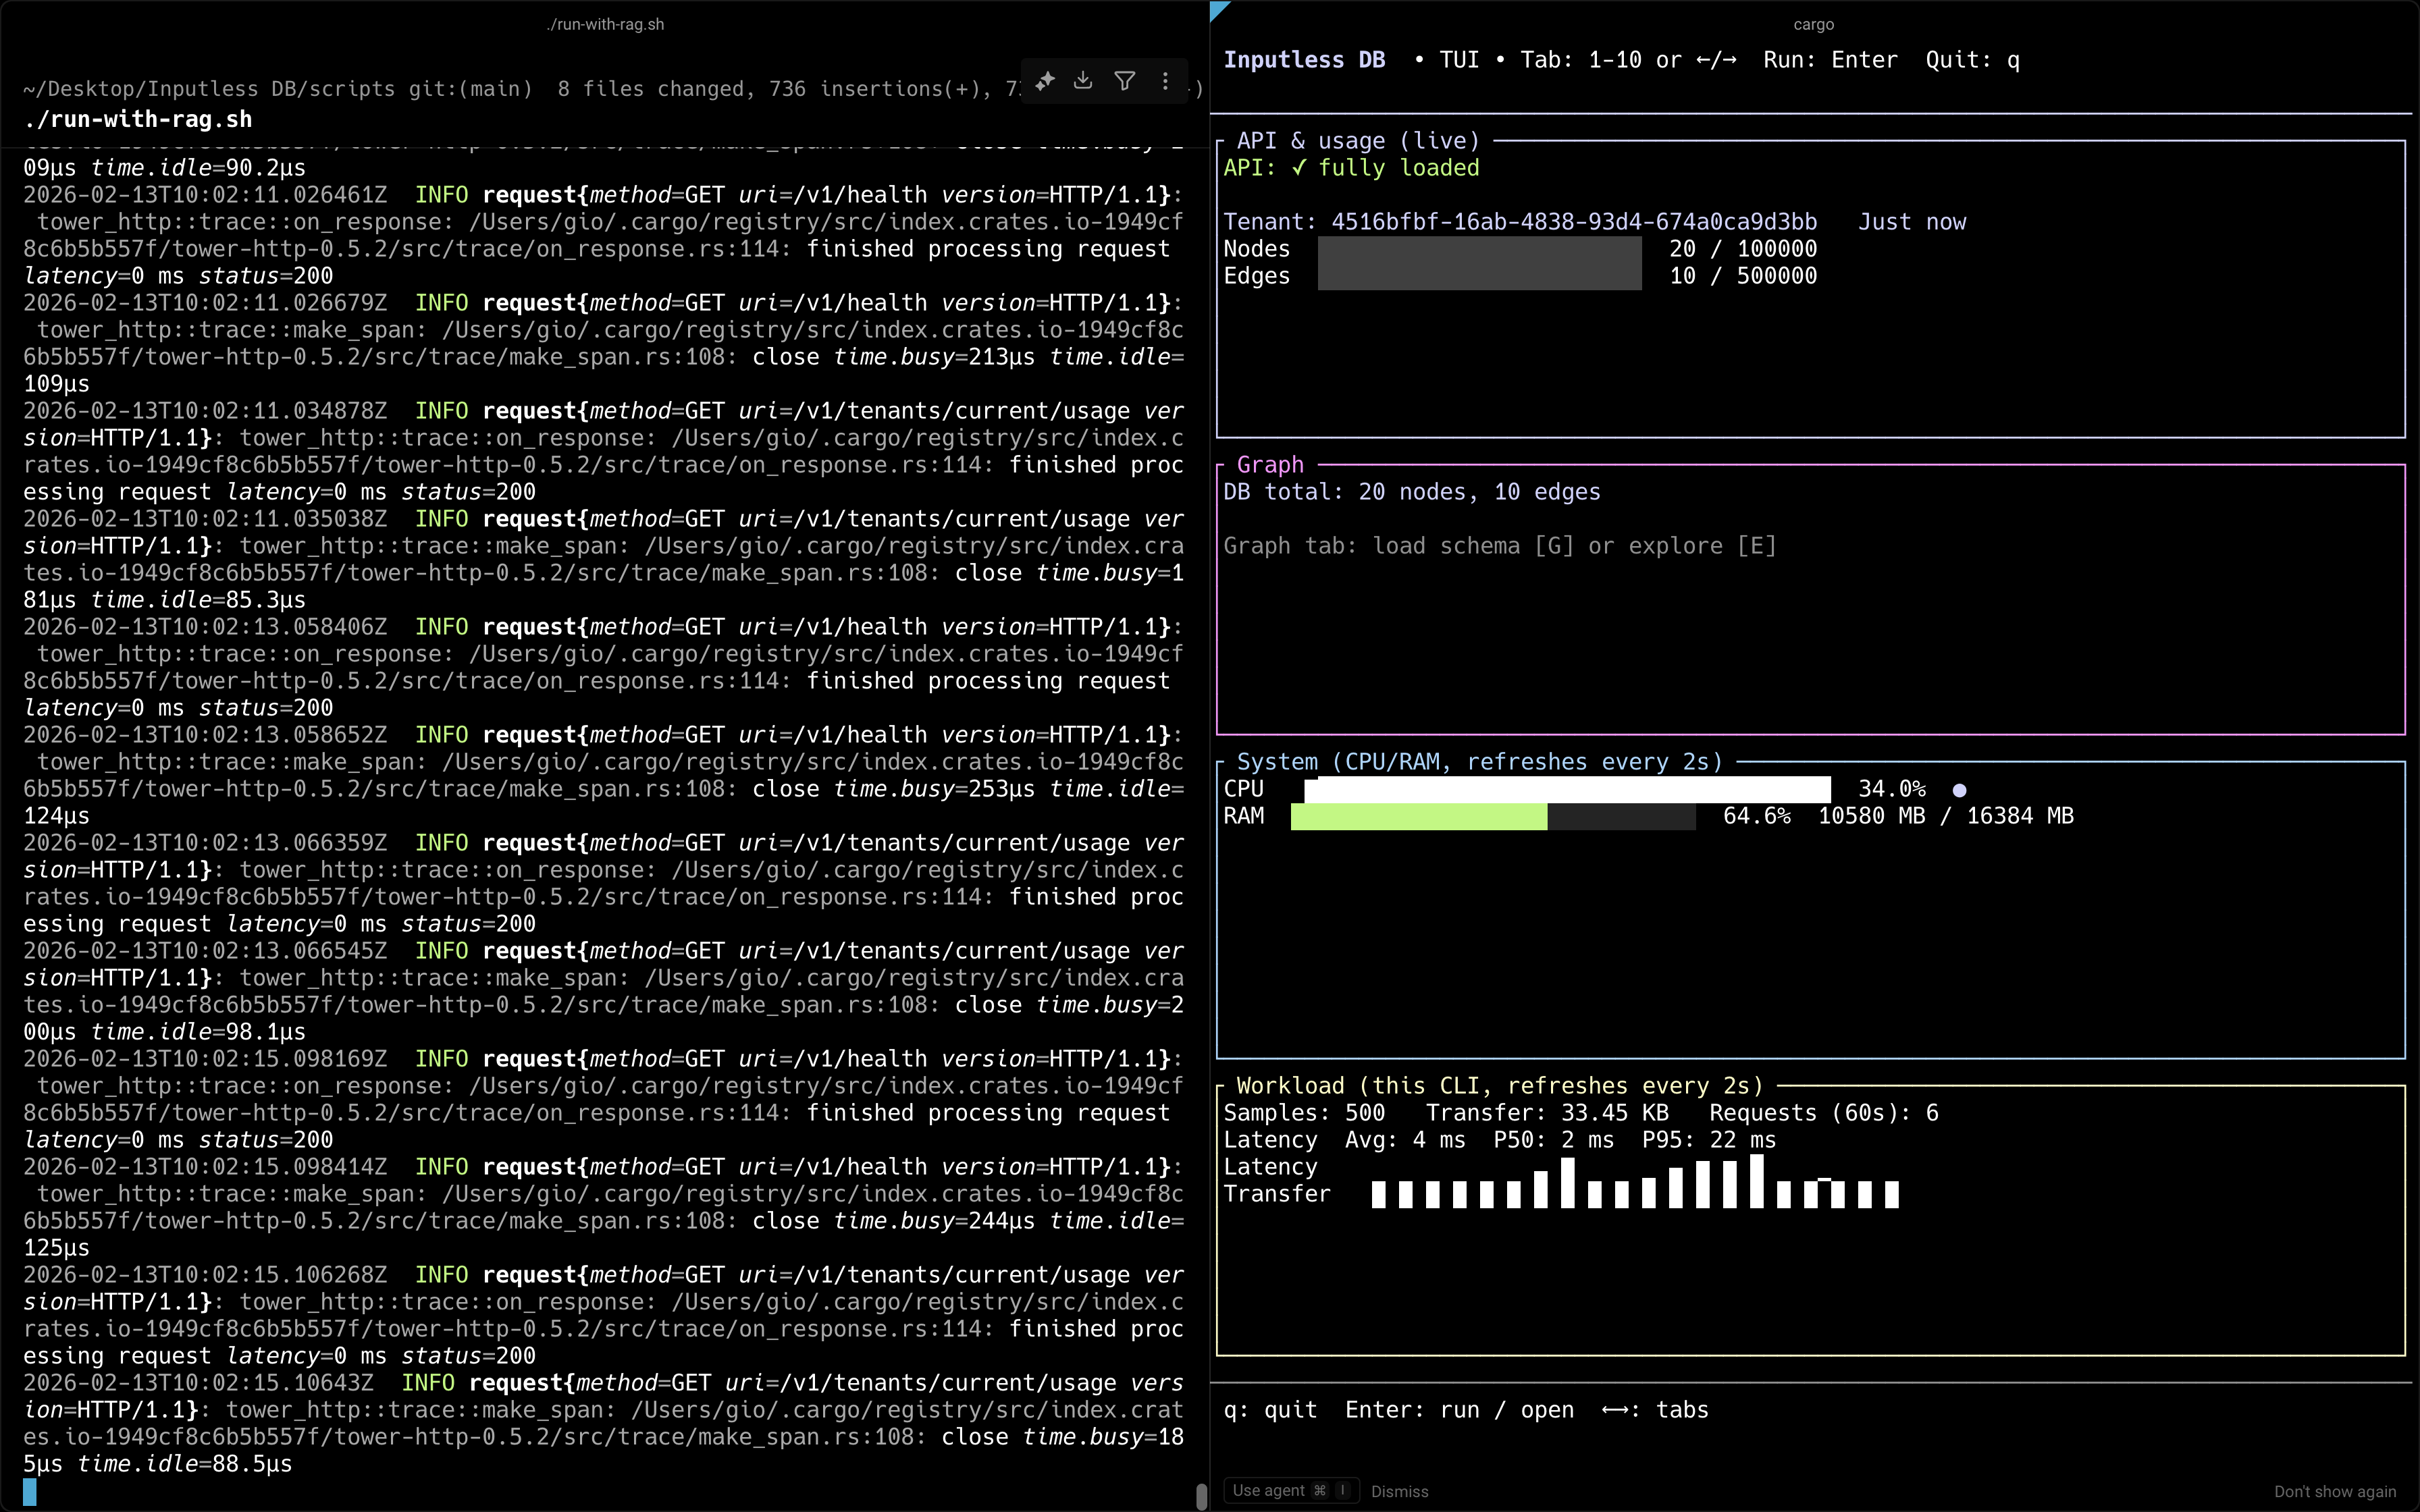
CLI di Inputless DB: interfaccia a terminale per monitorare la salute delle API, l’uso tenant (nodi/archi), i totali del grafo, le risorse di sistema (CPU/RAM) e il workload CLI con latenza e metriche di trasferimento.
.png)
Graph Explorer: risultato di query con nodi Document, Entity, Topic e relazioni CONTAINS_ENTITY, HAS_TOPIC. Cliccate un nodo per vedere i dettagli e tracciare le spiegazioni fino al sottografo.
.png)
Tipi di nodo (Document, Entity, Event, Topic) e tipi di relazione (CONTAINS_ENTITY, HAS_TOPIC, INVOLVES, LOCATED_IN, MEMBER_OF, ecc.) in un grafo unificato — comportamentale e semantico nelle stesse API.
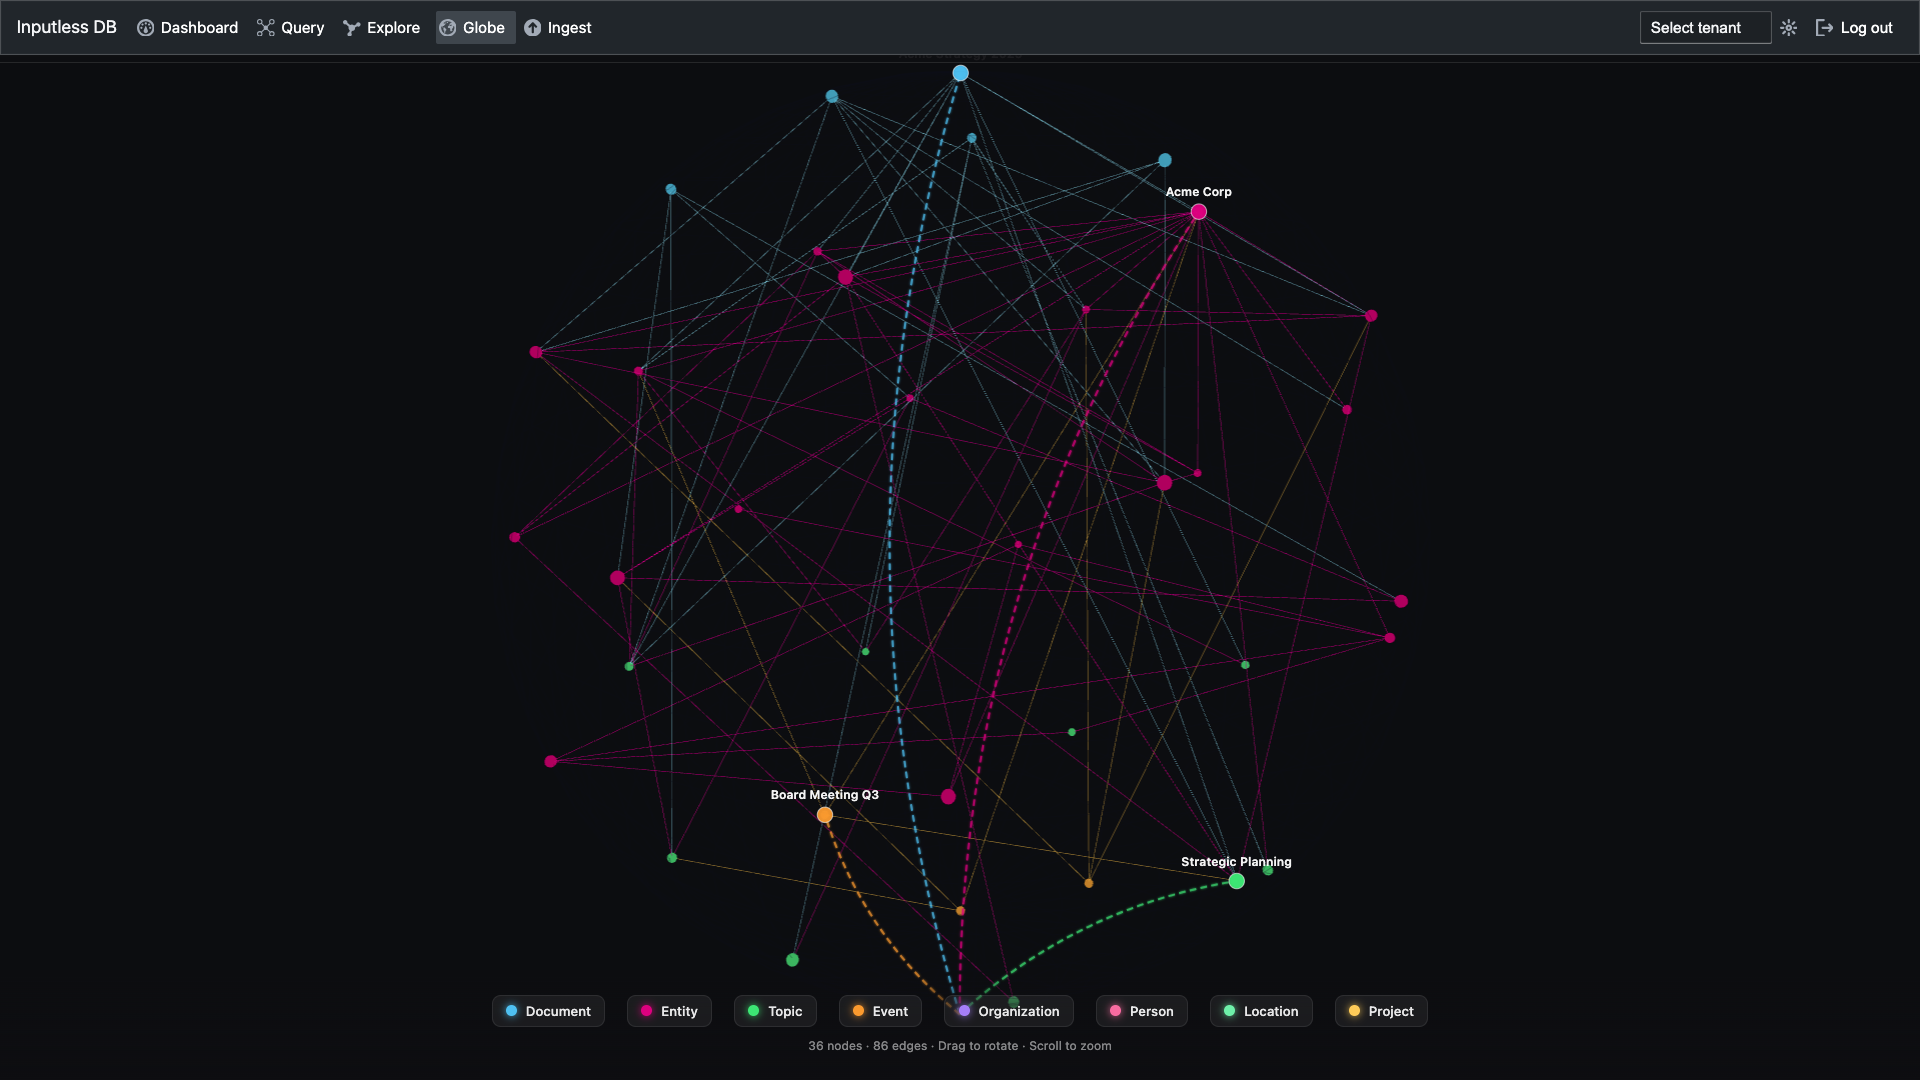
Vista grafo completa: organizzazioni, eventi, topic ed entità (es. Acme Corp, Board Meeting Q3, Strategic Planning). Scope trasparente (conteggi nodi/archi) e dimensioni cognitive-first.
La spiegazione è una query, non un log
Con Inputless DB, ogni risposta e decisione si può tracciare fino a un sottografo. Esplorate il grafo, filtrate per etichetta e relazione e ispezionate le proprietà dei nodi — tutto con le stesse API e lo stesso grafo per ciò che è stato detto e ciò che è stato fatto.
Fate il deploy di Inputless DB