Inputless DB
Base de datos en grafo. Documentos de entrada, subgrafo de salida. Una respuesta que pueden recorrer.
Qué obtienen
- •Carguen documentos sin ETL. Ingerir contenido de forma directa: sin pipelines manuales ni pasos de transformación. Inputless DB acepta los documentos tal cual y construye el grafo a partir de ellos.
- •El grafo se construye e informa automáticamente. El sistema construye y mantiene el grafo a partir de sus datos y lo muestra en el Graph Explorer: sin esquemas hechos a mano ni mapeo manual.
- •El informe de correlación del grafo conecta los datos automáticamente. Las conexiones entre entidades, topics, eventos y documentos se descubren e informan de forma automática, así que relaciones y explicaciones están siempre al día.
- •Escala hasta petaflow. Hecho para manejar flujo y throughput a escala petabyte. Inputless DB está diseñado para cargas enterprise y de intelligence donde el volumen y la velocidad exigen capacidad de grado petaflow.
- •Hecho para entornos airgapped. Redes aisladas, offline o de alta seguridad. Sin nube pública. Sin APIs externas. El modelo corre donde la conectividad está restringida o prohibida.
Cómo lo diseñamos
Cinco reglas que hacen de Inputless DB un almacén en grafo para RAG y el Cognitive Substrate, no un property graph genérico.
Anticipación por encima de reacción
Funciones que predicen o precalculan lo que se va a necesitar, no solo responden cuando se pregunta.
Cognitive como first-class
Intención, patrones y estado mental son dimensiones primarias del grafo y de la recuperación, no filtros secundarios.
Explicación graph-native
Cada respuesta y decisión se puede trazar hasta un subgrafo; la explicación es una consulta, no un log.
Conductual + semántico unificados
El mismo grafo y las mismas APIs para «lo que se dijo» y «lo que se hizo»; similitud sobre ambos.
Acotado y transparente
Los contratos (tiempo, presupuesto de nodos, confianza) son explícitos y first-class.
Graph Explorer en acción
Graph Explorer de Inputless DB: rastreen respuestas hasta subgrafos, exploren tipos de nodo y relaciones, y vean datos cognitivos y de comportamiento en una vista unificada.
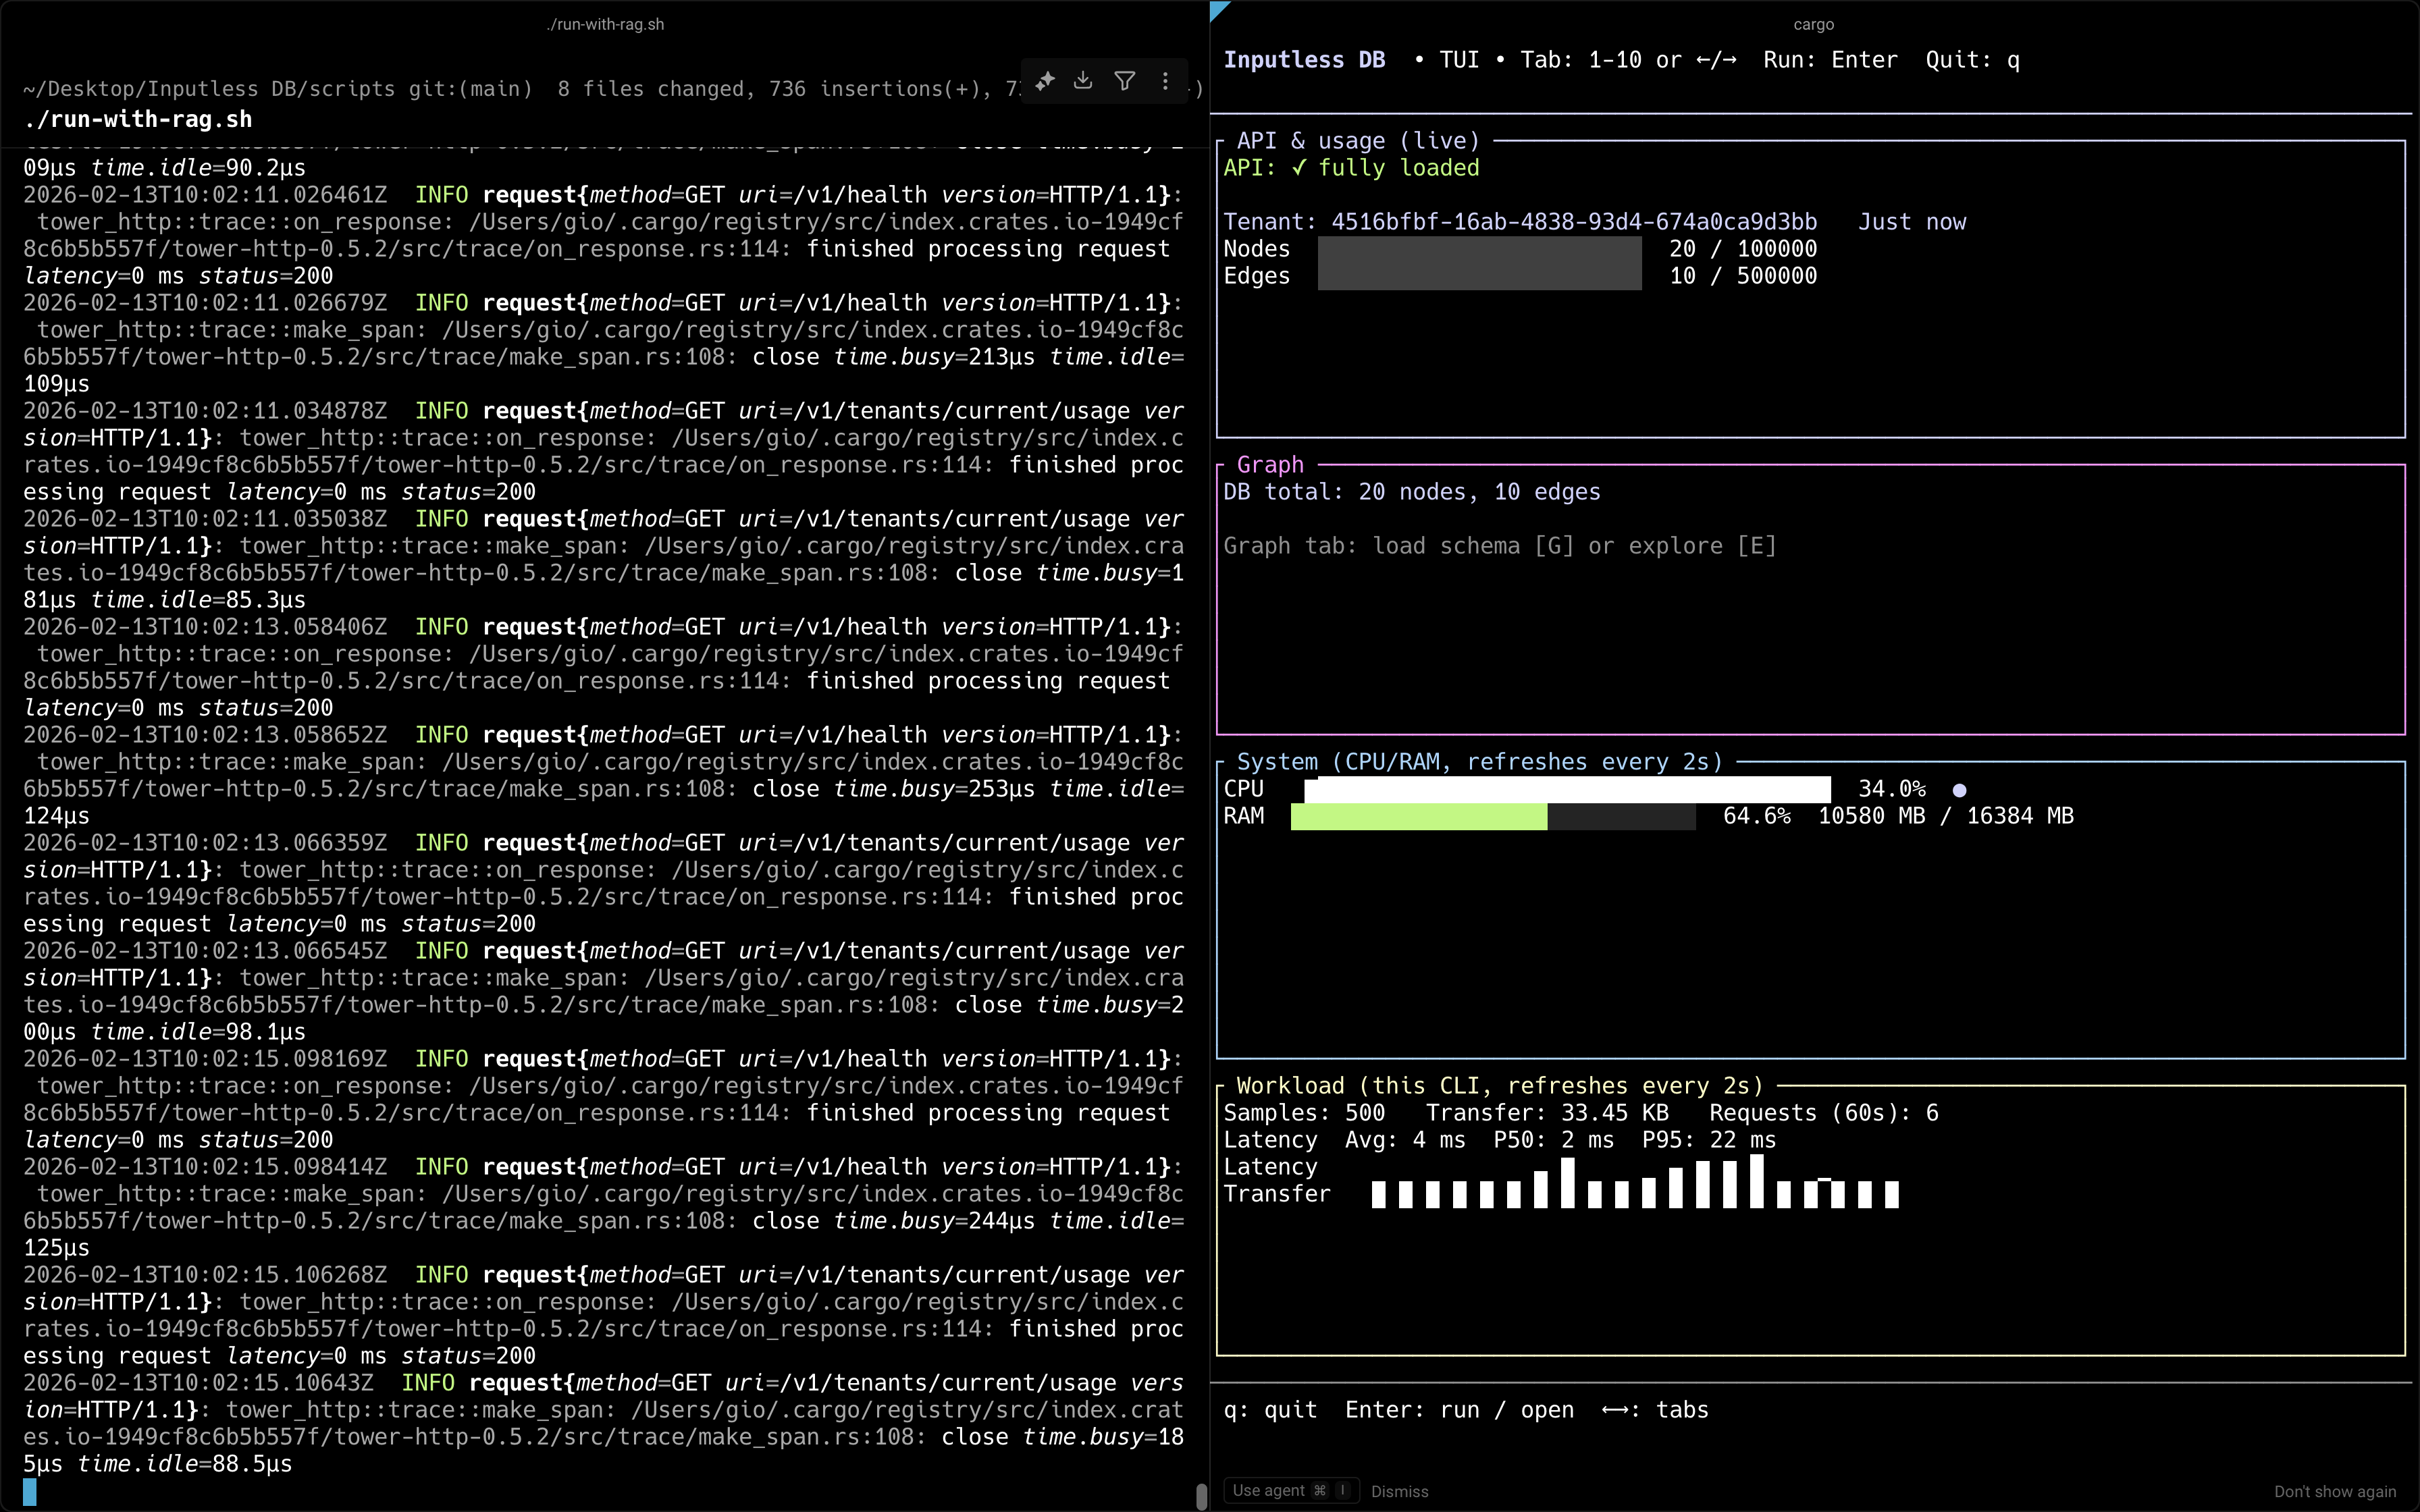
CLI de Inputless DB: interfaz de terminal para vigilar la salud de las API, el uso del tenant (nodos/aristas), los totales del grafo, los recursos del sistema (CPU/RAM) y la carga CLI con latencia y métricas de transferencia.
.png)
Graph Explorer: resultado de consulta con nodos Document, Entity, Topic y relaciones CONTAINS_ENTITY, HAS_TOPIC. Hagan clic en un nodo para ver detalles y rastrear explicaciones hasta el subgrafo.
.png)
Tipos de nodo (Document, Entity, Event, Topic) y tipos de relación (CONTAINS_ENTITY, HAS_TOPIC, INVOLVES, LOCATED_IN, MEMBER_OF, etc.) en un grafo unificado: conductual y semántico en las mismas APIs.
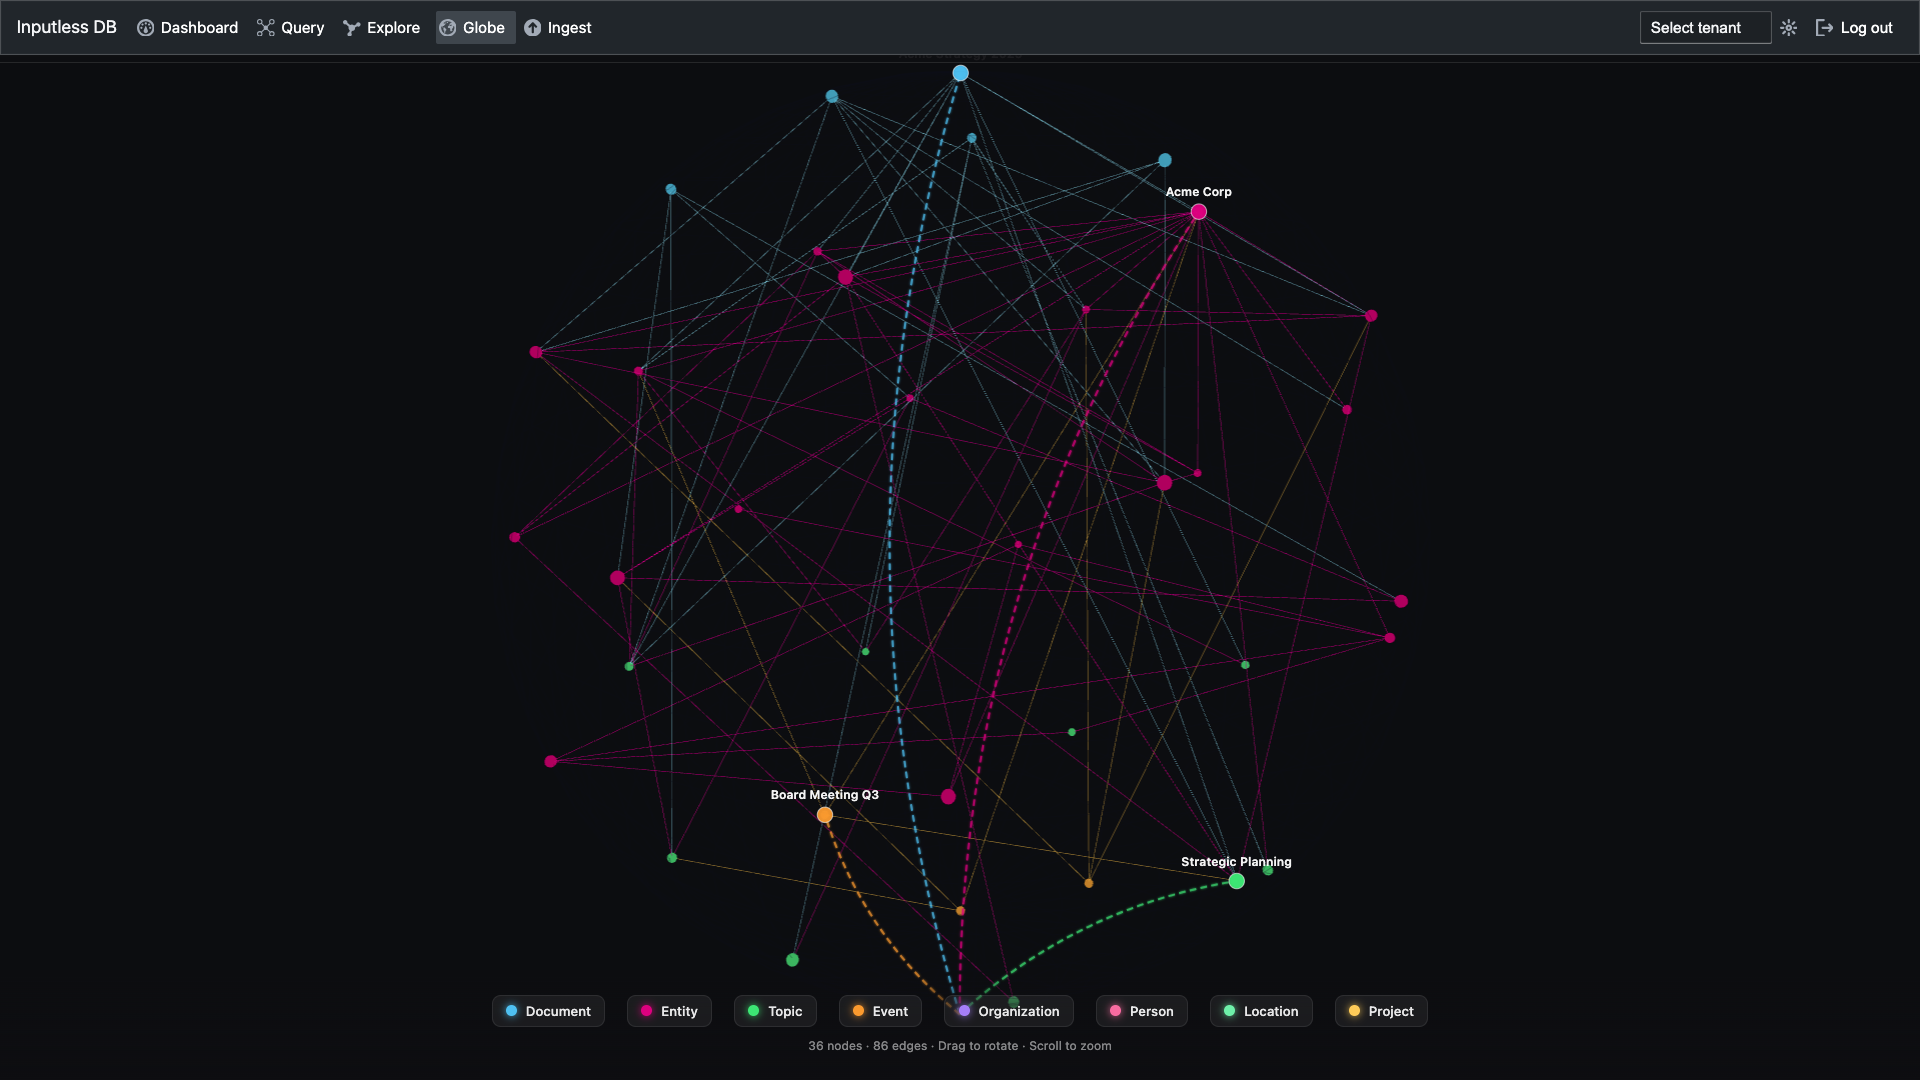
Vista de grafo completa: organizaciones, eventos, topics y entidades (p. ej. Acme Corp, Board Meeting Q3, Strategic Planning). Alcance transparente (conteos de nodos/aristas) y dimensiones cognitive-first.
La explicación es una consulta, no un log
Con Inputless DB, cada respuesta y decisión se puede trazar hasta un subgrafo. Exploren el grafo, filtren por etiqueta y relación e inspeccionen las propiedades de los nodos, todo con las mismas APIs y el mismo grafo para lo que se dijo y lo que se hizo.
Desplieguen Inputless DB